급수 대신, 실제로 어려워지는 지점 회화 코퍼스 단어 빈도를 누적했을 때 토큰 커버리지 55% / 60% / 70% / 80%에 닿는 순위 경계입니다. CEFR·HSK 같은 급수 대신 실측 breakpoint로 레벨을 나눕니다.
회화 골격
기능어·대명사·종조사/종결사·기초 동사. 언어마다 골격이 다름 — 러시아어=격·전치사, 베트남어=호칭+어감종결사, 태국어=종조사+대명사, 일본어=조사, 중국어=한자 커버.
일상 핵심어
부정·시제·접속·핵심 동사.
자주 쓰는 어휘
일상 어휘 본진 — '절벽의 진짜 위치'. 감정·관계 동사.
폭넓은 어휘
일상 명사·형용사 확장. 문장 레벨은 문장 안 가장 희귀한 단어의 구간으로 정해, R1 문장만 읽으면 R1 단어만 나오게 합니다. R5(90%)+ 단어가 섞인 문장은 빼기.
러시아어 — R1 156 레마가 격 시스템을 한 바퀴 닫는다 자국 제작 영화·드라마 자막을 pymorphy3 레마 단위로 집계 · 러시아어 앱이 베트남어·태국어 앱 방법론의 원형
| 구간 | 누적 | 레마 수 · 앱 채택 | 경계 단어 | 전체 자막 레마 수 | 경계 |
|---|---|---|---|---|---|
| R1 | 55% | 156 | сказать INFN | 146 | сказать |
| R2 | 60% | 251 | ночь NOUN | 230 | возможно |
| R3 | 70% | 685 | заниматься VERB | 630 | прежде |
| R4 | 80% | 1,985 | гораздо ADVB | 1,912 | художник |
| R5 | 90% | (Top 5000 미도달) | — — | 7,044 | порох |
앱 채택 = 자국 제작물만 추린 코퍼스(작품 메타데이터 language=ru + 공개 메타데이터 국가 교차). 오른쪽은 공개 자막 러시아어 자막 전체(영화 7,452 + 드라마 325편, 8,755만 토큰) — 레마라서 표면형보다 훨씬 적은 단어로 같은 커버리지에 닿고, R5(90%)는 7,044 레마. 앱은 R1~R4를 L1~L4로 부릅니다.
R1 토큰 비중 — 품사별
대명사 12개가 토큰의 11.6%. 기능어(대명사·전치사·접속사·필러) 58개가 R1 토큰의 38%.
격 — R1 안에서 이미 다 시연된다
| 격 | R1 동사 직접 지배 | R1 전치사 결합 |
|---|---|---|
| 대격 | 18 동사 | 방향 в·на |
| 생격 | 4 동사 | у·из·от·до·для·без |
| 여격 | 4 동사 | к·по |
| 조격 | 2 동사 (быть·стать) | с |
| 전치격 | (직접 거의 없음) | в·на·о |
격은 한국어 조사(은/는·을/를·에게·의·로·에서)와 1:1로 대응해 한국인에게는 영어보다 쉽다 — 진짜 보스는 상(вид).
R1 156 레마 전체 숫자 = 빈도 순위 · 올리면 빈도와 누적 %
대명사 12개
я1 ты3 вы8 он9 мы14 они25 она26 кто32 что57 это66 себя74 никто137
전치사 14개
в7 на10 с13 у18 за28 к30 по34 о38 из49 от64 до72 для77 без103 под150
접속사·종속사 16개
а4 и5 что6 как17 так21 то22 но33 если52 когда70 ли84 куда91 чем92 чтобы97 или104 значит106 конечно113
불변화사·필러 16개
не2 ну11 это12 да15 всё19 вот20 же23 бы40 ведь82 тоже90 пожалуйста94 ни95 ж116 просто125 даже136 ка148
부사 21개
ещё44 только46 там56 где59 сейчас60 здесь63 ничего65 хорошо71 очень73 почему78 теперь79 уже80 тут81 зачем112 сюда117 тогда118 сегодня119 потом126 пока141 уж145 сколько147
형용사(완전형) 17개
мой29 какой35 такой36 этот37 весь42 ваш45 один48 наш50 свой51 тот58 сам61 твой75 который101 другой110 хороший123 первый132 самый153
형용사(단형) 2개
должный100 ладный127
동사(정동사) 26개
быть16 мочь27 знать31 говорить41 хотеть43 давать53 сказать55 идти62 пойти69 видеть76 понимать83 думать86 просить93 дать99 взять114 нибыть115 любить120 понять121 стоить122 смотреть124 прийти134 стать138 слушать142 жить151 ждать152 слышать155
동사(부정사) 3개
есть54 быть87
술어부사(надо/нужно류) 3개
нет24 надо47 можно105
명사 20개
человек39 дело67 товарищ68 раз85 год89 день96 жизнь102 дом107 время108 друг109 рука128 господин129 мама131 бог135 отец139 слово140 место143 ребёнок146 ребята149 работа154
감탄사 3개
спасибо88 ой98 здравствуйте133
수사 1개
два111
비교급 2개
большой130 хороший144
R1 동사 26개 활용 분류
| 분류 | 개수 | 동사 |
|---|---|---|
| 1식 완전 규칙 | 4 | знать · понимать · думать · слушать |
| 2식 완전 규칙 | 4 | говорить · стоить · смотреть · слышать |
| 1식 변형 | 7 | давать · сказать · взять · понять · стать · жить · ждать |
| 2식 변형 | 3 | видеть · просить · любить (1인칭 자음 교체) |
| 불규칙 | 8 | быть · есть · мочь · хотеть · дать · идти · пойти · прийти |
규칙 동사 두 종류(1식·2식)가 R1에 모두 노출. 불규칙 8개가 최고빈도(быть 11위·мочь 22위) — 규칙 엔진(트랙 A)과 통문장 암기(트랙 B)로 분리.
전치사 + 격 빈도 Top 10
| 전치사 | 격 | 빈도 |
|---|---|---|
| в | 전치격 | 95,885 |
| с | 조격 | 78,485 |
| в | 대격 | 52,686 |
| у | 대격 | 48,525 |
| у | 생격 | 46,241 |
| к | 여격 | 45,157 |
| на | 대격 | 44,101 |
| на | 전치격 | 41,647 |
| в | 주격 | 35,692 |
| по | 여격 | 33,156 |
설계 결정
- R1 = 자국 영화·드라마 — 고유 문장 다양성이 채팅 대비 1.43배(R1 96,573 vs 67,327). 격 시연·어휘 다양성에 유리.
- R2 = 텔레그램 채팅(1,046만 발화) — "R2에서 실제 챗을 해 보라"는 설계. SNS 친숙 + 실전 연결.
- R4 = greedy set cover 1,000문장 — R4 1,275 레마를 100% 노출(500문장이면 39%만).
- R1 문장 길이 ≥ 3단어 — 무료 버전에 'Да' 한 단어만 보이면 학습 가치가 낮아 보여 전환 실패.
- 분량 R1 300 + R2 500 + R3 500 + R4 1,000 = 2,300문장 · 가중치 R1·R3 격 시연 35% / R2·R4 빈도 50% · R5 제외('최소 어휘 최대 문장').
- 문장빈도 큐레이션 성립 — 301만 발화라 흔한 문장이 수백 번 반복돼 빈도 순위가 의미 있음(저자원 언어에선 불가 → 태국어·베트남어는 패턴빈도로 대체).
태국어 — 종결사·대명사·상표지가 R1이다 태국 원어 작품 50편 · pythainlp newmm 분절 · 격이 없는 언어에서 무엇이 '골격'이 되는가
| 구간 | 누적 | 단어 수 | 누적 단어 · 앱 채택 | 공개 자막 누적 | 차 | 공개 자막 경계 단어 | 작품 보편성 CD |
|---|---|---|---|---|---|---|---|
| R1 | ~55% | 109 | 109 | 99 | +10 | สิ่ง | 91.8% |
| R2 | ~60% | 40 | 149 | 137 | +12 | คุย | 87.8% |
| R3 | ~70% | 146 | 295 | 286 | +9 | เยี่ยม | 56.0% |
| R4 | ~80% | 347 | 642 | 653 | −11 | โบ | 33.3% |
| R5 | ~90% | 1023 | 1665 | — | — | — | — |
절벽 수렴 검증 — 독립 코퍼스 공개 자막(영화 자막 39,129편 · 2.53억 토큰, 사극 제외)와 원어 코퍼스(260,333 토큰)는 규모가 약 6,000배 다른데 R1~R4 경계가 ±10단어로 일치합니다. 코어 약 80단어(기능어·기본 종결사)는 레지스터와 무관해 수렴하고, 주변부 약 20단어가 번역체(공개 자막: การ·พวกเขา·ท่าน이 R1 진입) ↔ 원어(원어 코퍼스: พี่·มึง·กู·ครับ·ค่ะ가 R1 최상위) 축에서 갈립니다. 그래서 회화 앱의 단어·레지스터·종결사는 원어 코퍼스를 1순위로 삼습니다.
기능 클래스 × 구간 단어 수 (토큰 비중) — R1은 기능어, R4로 갈수록 내용어
| 기능 클래스 | R1 | R2 | R3 | R4 | 누적 단어 |
|---|---|---|---|---|---|
| 종결사 SFP | 17 (9.6%) | 1 (0.1%) | 6 (0.4%) | 1 (0.0%) | 25 |
| 대명사 PRON | 14 (8.7%) | 3 (0.4%) | 3 (0.3%) | 4 (0.1%) | 24 |
| 상·양태 ASPECT | 9 (6.4%) | – | 4 (0.3%) | 1 (0.0%) | 14 |
| 동사 VERB | 14 (5.1%) | 5 (0.6%) | 23 (1.6%) | 48 (1.5%) | 90 |
| 부정 NEG | 2 (2.4%) | – | – | – | 2 |
| 의문사 Q | 5 (1.9%) | – | 1 (0.1%) | 2 (0.1%) | 8 |
| 전치사 PREP | 6 (3.2%) | 1 (0.1%) | 1 (0.1%) | 2 (0.1%) | 10 |
| 접속사 CONJ | 6 (3.9%) | 2 (0.3%) | 8 (0.5%) | – | 16 |
| 불변화사 PRCL | 2 (0.7%) | 1 (0.1%) | 3 (0.2%) | – | 6 |
| 지시 DEM | 4 (1.6%) | – | 2 (0.2%) | 3 (0.1%) | 9 |
| 부사 ADV | 3 (0.8%) | 3 (0.4%) | 3 (0.2%) | 15 (0.5%) | 24 |
| 형용사 ADJ | – | – | – | – | 0 |
| 명사 NOUN | 22 (9.5%) | 20 (2.5%) | 80 (5.4%) | 259 (7.2%) | 381 |
| 감탄사 INTJ | 3 (0.7%) | 3 (0.4%) | 7 (0.5%) | 5 (0.2%) | 18 |
| 수사 NUM | 1 (0.2%) | 1 (0.1%) | 3 (0.2%) | 7 (0.2%) | 12 |
| 비교 COMP | 1 (0.2%) | – | 2 (0.1%) | – | 3 |
| 합계 | 109 | 40 | 146 | 347 | 642 |
R1 109단어 전체 빈도순 · 기능 클래스별
종결사 SFP 17개
นะ ครับ เลย อะ ค่ะ เหรอ เนี่ย ไหม น่ะ ไง วะ คะ นะคะ สิ ล่ะ เปล่า หรอก
대명사 PRON 14개
มัน เรา พี่ มึง คุณ ผม กู ฉัน เขา เธอ พวก หนู แก ยู
상·양태 ASPECT 9개
แล้ว จะ ได้ อยู่ ต้อง อยาก ยัง ไว้ เคย
동사 VERB 14개
มี เป็น ทำ เอา คือ ใช่ รู้ บอก คิด ดู ช่วย ขอ เห็น กิน
부정 NEG 2개
ไม่ อย่า
의문사 Q 5개
อะไร ทำไม ใคร ไหน ยังไง
전치사 PREP 6개
ที่ ของ กับ ด้วย ใน ถึง
접속사 CONJ 6개
ก็ ว่า แต่ ถ้า และ งั้น
불변화사 PRCL 2개
กัน เอง
지시 DEM 4개
นี่ นี้ นั้น แบบนี้
부사 ADV 3개
ดี มาก จริงๆ
명사 NOUN 22개
ไป มา ให้ ๆ คน ไอ้ แม่ เดี๋ยว ก่อน อีก แบบ เรื่อง แค่ หน่อย อย่าง ลูก พ่อ วัน ง ชอบ พูด บ้าน
감탄사 INTJ 3개
เฮ้ย เออ ขอบคุณ
수사 NUM 1개
สอง
비교 COMP 1개
กว่า
R2 40단어60% · 누적 149
종결사 SFP 1개
ดิ
대명사 PRON 3개
เค้า นาย น้อง
동사 VERB 5개
เล่น หา กลับ ทำให้ รอ
전치사 PREP 1개
จาก
접속사 CONJ 2개
แล้วก็ เพราะ
불변화사 PRCL 1개
บ้าง
부사 ADV 3개
ใช่ไหม เร็ว จริง
명사 NOUN 20개
ไม่ต้อง หมด เหี้ย เว้ย ออก ขึ้น วันนี้ ตอนนี้ ก็ได้ การ เจอ พอ ทุกคน ขอโทษ เด็ก คุย เหมือน งาน บอ ที่นี่
감탄사 INTJ 3개
โอเค อ้าว สวัสดี
수사 NUM 1개
หนึ่ง
R3 146단어70% · 누적 295
종결사 SFP 6개
ว่ะ ฮะ จ้ะ เถอะ เนอะ มั้ย
대명사 PRON 3개
ท่าน ตัวเอง พวกเรา
상·양태 ASPECT 4개
กำลัง น่าจะ เพิ่ง อาจจะ
동사 VERB 23개
ตาย ซื้อ เกิด เข้า ส่ง ใช้ เข้าใจ ทำงาน เหมือนกัน ขาย เรียก เก็บ กลับมา เข้ามา รู้จัก เริ่ม นึง ตั้ง เลือก เรียน พร้อม ใส่ รับ
의문사 Q 1개
หรือเปล่า
전치사 PREP 1개
ตาม
접속사 CONJ 8개
เพื่อ หรือ ทั้ง แต่ว่า ที่จะ ตั้งแต่ จน เพราะว่า
불변화사 PRCL 3개
ละ แหละ ซะ
지시 DEM 2개
อย่างนี้ นั่น
부사 ADV 3개
ใหม่ ใจ นาน
명사 NOUN 80개
เมษา เพื่อน ปะ เวลา ขนาด คง เจ๊ ปี ถาม ตัว กะ ดีกว่า เยอะ หน้า ฟัง พา รัก ปล่อย ห้อง เงิน ชื่อ เพลง ไม่เป็นไร ลอง ลง โดน ถูก รีบ ทาง เม ต่อ หมอ สัก แนน โน๊ะ เข้าไป ลืม คนเดียว ไอ น่า ใจเย็น นั่ง แน่ เจ ตอน ผู้หญิง เกม สัตว์ นอน เชื่อ ออกมา ครู หยุด จูน เชี่ย สวย รู้สึก เดียว บอส ทุก ชีวิต จัง น้ำ แฟน เก่ง อยู่แล้ว เหมียว อี โทร เชิญ ฮิลล์ อาม่า ได้ยิน หลาย ร้าน บริษัท สิ่ง เลิก จับ พอดี
감탄사 INTJ 7개
อือ เอ่อ โอ๊ย อ๋อ เอ๊ย เอ้า อืม
수사 NUM 3개
สาม ห้า สี่
비교 COMP 2개
ที่สุด มากกว่า
R4 347단어80% · 누적 642
종결사 SFP 1개
ครับผม
대명사 PRON 4개
เอ็ง ข้า เจ้า พวกเขา
상·양태 ASPECT 1개
ควร
동사 VERB 48개
เปิด ดูแล เสร็จ จบ ใหญ่ ฝาก ผ่าน ติด ทิ้ง จัดการ ผิด จ่าย เหลือ สอน ถ่าย ปิด เปลี่ยน สำคัญ ยาก เสีย ตอบ จัด เพิ่ม เดิม ยิง วัด ขอให้ แปล พยายาม สั่ง เขียน ตั้งใจ อ่าน พบ ต้องการ ยุ่ง แน่นอน เล็ก พวกคุณ แทน เกิดขึ้น ตกลง แก้ สร้าง เตรียม วาง ยินดี ออกแบบ
의문사 Q 2개
กี่ เท่าไร
전치사 PREP 2개
สำหรับ บน
지시 DEM 3개
อันนี้ ตรงนี้ งี้
부사 ADV 15개
เจอกัน ด้วยกัน แล้วกัน ปกติ ต่อไป ให้ได้ ยิ่ง สุด น้อย เรียบร้อย นัก ตลอด ง่าย เรื่อยๆ ใบ
명사 NOUN 259개
ริน กลัว ทีม โลก ที ตำรวจ ฆ่า รถ ไหว โคตร ตี๋ แรก ผู้ชาย คนอื่น ทุกอย่าง ค่า เหอะ เดิน เสียง ทั้งหมด กลับบ้าน ส่วน ยอม อา ลุง รอบ เฮีย นั่นแหละ ดาว หาย ป้า น้า ไปหา เป็นไง คืน จำ ไทย เมื่อ เปียโน เดือน บ้า ทัน ไร เอ ทำได้ ทอย ริ หรือว่า เล่า ลา ต้น ตา แค่นี้ ดีใจ ชุด แก้ว อร่อย หนี ส พรุ่งนี้ เมื่อกี้ เนี้ย ใกล้ รอด ซิ วิน ที่ไหน เดย์ หลัง ลูกค้า ข้อมูล โทษ อยากได้ หลอก ป๊า กาย อีกแล้ว หรือยัง มอง บาท ซัน ชนะ วิธี เมีย เดี๋ยวนี้ สู้ สุดท้าย มือ มาจาก เดอะ วิ ระวัง มีเรื่อง สามารถ น ไม่ค่อย เบน เจ็บ ห้าม เหยื่อ อาจารย์ นี่แหละ คืนนี้ แอม แป๊บ อายุ มั้ง นี้แหละ คำ เอาไว้ อัน ว่าง หรือไม่ สาย สบาย น่ารัก ตื่น ตอนนั้น ตรง เอก หรือไง ดีมาก ฉิบหาย แรง เมื่อไหร่ ครั้ง ข่าว ประเทศ ค่อย เร อื่น หนิง สนใจ ยา ปูนา ตอนที่ ความ ฆาตกร ไปดู แปลก เหนื่อย สนุก ผู้กอง โดย สี วันที่ ซอล ชวน ค่อยๆ คุณแม่ โรงเรียน เสี่ย หัว รูป โอ แน่ๆ เลือด เฉย เกา ย ซึ่ง จำได้ ครอบครัว ขา แตก ยืน นะเนี่ย คดี ขอบใจ โต แล้ อีกที อาหาร ลัน นาที อู๊ด หล่อ ยาย ไฟ โอ้ แพ้ เจ้าค่ะ หมาก สัญญา รู้เรื่อง พระ นึก คอย แข่ง เป็นเพื่อน หิว ร้อง ฝัน ดัง โชว์ เรือ สาว วจะ ด็อบ ข้าง ห่วง มีความสุข ดี้ จ๊ะ กล้า แย่ แน่ใจ วันนั้น ปาก ดีแล้ว กินข้าว โจ้ แพง แดก เผื่อ หวัง ชั่วโมง โอน แผน เสียใจ เย็น หัวหน้า หมู สิง มาหา บ็อบ ถ่ายรูป เสือก เทพ สม รึ ยัย ด่วน จี คงจะ โมง เอ็ม เลิฟ เดียวกัน เจ้าคะ อร หัวใจ หัน มานะ มาถึง ปลอดภัย ด่า ช่วยด้วย คุณพ่อ ๆๆ ออเจ้า หนัง สักที ล ฝึก ฝรั่ง ตังค์ คบ คลิป
감탄사 INTJ 5개
โห หือ อุ๊ย ฮัลโหล โอ้โห
수사 NUM 7개
สิบ ล้าน หก แปด ร้อย พัน เก้า
어감 종결사 → 한국어 성별 공손 ครับ/ค่ะ = 한국 존댓말과 직접 대응, 단 성별 차원은 한국어에 없음
| 종결사 | 원어 빈도 | 어감 → 한국어 |
|---|---|---|
| นะ/น่ะ | 2,380 | 부드러움 → ~네/~거야 |
| ครับ(남)·ค่ะ/คะ(여) | 3,300+ | 공손(성별!) → ~요/~습니다 |
| เหรอ | 898 | 되물음 → ~야?/~어? |
| สิ | 332 | 명령·재촉 → ~봐/~라니까 |
| ไง | 469 | 당연 → ~잖아 |
| ล่ะ | 327 | 화제전환 의문 → ~은?/왜? |
정중도 정책 — 사극 격리 공개 자막 기준 · CD = 작품 보편성
| 순위 | 단어 | CD | 분류 | R1 포함? |
|---|---|---|---|---|
| 1위 | ฉัน | 93.6% | 여/중성 1인칭 | ✅ |
| 8위 | ผม | 92.7% | 남 1인칭 격식 | ✅ |
| 4위 | คุณ | 93.5% | 격식 you | ✅ |
| 17위 | เธอ | 92.3% | 친근 you | ✅ L2 |
| 16위 | มัน | 99.7% | it/그(친근) | ✅ L2 |
| 52위 | ข้า | 23.1% | 사극 1인칭 | ❌ 블랙리스트 |
| 72위 | เจ้า | 60.2% | 사극 you / "주인" | ⚠️ 일반 의미만 |
| 562위 | กู | 15.3% | 친밀 거친 1인칭 | ⚠️ R3 후반 별도 |
| 1046위 | มึง | 3.65% | 친밀 거친 you | ⚠️ R4 밖 |
친밀 회화는 포함, 사극은 제외. 사극 블랙리스트 904개(수동 24 + 자동 624 + 노이즈 265), 저-CD라도 보존할 화이트리스트 29개(กู·มึง·ครู·ลุง·บาท 등).
의미 결합 청크 Top 10 공개 자막 PMI 필터(NPMI ≥ 0.4, 빈도 ≥ 100) 통과 285개 중 t-score 순
| # | 청크 | 빈도 | NPMI | 뜻 |
|---|---|---|---|---|
| 1 | ไม่ ได้ | 1.04M | 0.44 | 할 수 없다 / 안 됐다 |
| 2 | ไม่ ใช่ | 584K | 0.45 | 아니다 |
| 3 | คิด ว่า | 470K | 0.62 | ~라고 생각하다 |
| 4 | รู้ ว่า | 381K | 0.49 | ~라고 알다 |
| 5 | ทำ อะไร | 330K | 0.49 | 무엇을 하다 |
| 6 | บอกว่า | 290K | 0.91 | ~라고 말하다 |
| 7 | สิ่ง ที่ | 261K | 0.55 | ~한 것 |
| 8 | อยู่ ใน | 233K | 0.43 | ~안에 있다 |
| 9 | แบบ นั้น | 216K | 0.70 | 그렇게 |
| 10 | ออก ไป | 201K | 0.51 | 나가다 |
설계 결정
- 원어만 — 외국 영화 번역 자막(공개 자막)이 아닌 태국 원어 작품. 공개 자막 태국 자국물은 영화 152 + 드라마 115편뿐이라 빈약.
- 문장 레벨 = 문장 안 가장 희귀한 단어의 구간 — R1 문장만 읽으면 R1 단어만 나오는 graded reader.
- 자연 필터 3토큰 이상 · 한국어 번역 있음 · 합본 대사 제외 · 중복 제거 → 풀 R1 1,280 / R1~R4 9,224(목표의 4배). 가치 점수(log 빈도 + 종결사 + 대명사 + 상·양태 + 길이) + 패턴당 상한.
- 분량 R1 200 · R2 500 · R3 500 · R4 1,000. R2는 구간 단어가 40개뿐이라 구조적 병목 → 50편 → 70편 확대 권장.
- 저작권 — 원작 한국어 번역은 그대로 쓰지 않고 자체 재번역. 분석은 통계만.
- 베트남어와 같은 파이프라인 — 계통(따이-까다이 vs 오스트로아시아)과 차용원(영어 vs 한자)이 다른데 코어 절벽 모양이 수렴. 단위가 달라(단어 vs 음절) 숫자가 아니라 모양으로 비교.
누적 커버리지 곡선 상위 N개 단어가 회화 토큰의 몇 %를 덮는가 — 17개 언어 공통 비교
17개 언어 비교표(talkverse-ja all17_cliff_summary)는 언어마다 출처가 다릅니다 — 자막 빈도표(en·de·es), 공개 병렬 자막 직접 처리(ko·ja·hi), 혼합 빈도표 혼합(fr·it·ru·pt·fa·ar·id·vi·tr), 자체 분절(th·zh). 그래서 위 카드의 '앱 채택 값'(각 앱 자체 코퍼스)과 숫자가 다르고, 언어 간 직접 비교는 경향만 보세요.
R1 크기 — 회화 골격이 작은 언어 순 공통 비교 기준 '비례 R1' — 상위 2,500단어가 닿는 최대 커버리지를 80%로 보고 비례 환산한 R1 경계(절대 55% 도달 수는 아래 표). 막대에 올리면 1위 단어
커버리지 도달 단어 수 누적 50~80%에 닿는 순위. 칸이 진할수록 많이 외워야 함 · '미도달' = 상위 2,500 안에서 그 %에 못 닿음
| 언어 | 50% | 55% | 60% | 65% | 70% | 75% | 80% |
|---|---|---|---|---|---|---|---|
| 영어 | 72 | 95 | 125 | 177 | 261 | 392 | 626 |
| 독일어 | 108 | 153 | 224 | 340 | 525 | 861 | 1514 |
| 스페인어 | 26 | 45 | 76 | 121 | 194 | 333 | 589 |
| 포르투갈어 | 135 | 234 | 403 | 681 | 1134 | 1901 | 미도달 |
| 프랑스어 | 70 | 102 | 155 | 240 | 385 | 638 | 1104 |
| 이탈리아어 | 153 | 225 | 329 | 494 | 761 | 1222 | 2069 |
| 러시아어 | 316 | 499 | 803 | 1338 | 2280 | 미도달 | 미도달 |
| 힌디어 | 1218 | 2472 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 |
| 페르시아어 | 353 | 530 | 775 | 1120 | 1626 | 2392 | 미도달 |
| 중국어 | 460 | 681 | 1006 | 1479 | 2186 | 미도달 | 미도달 |
| 아랍어 | 1218 | 1850 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 |
| 인도네시아어 | 267 | 403 | 603 | 895 | 1349 | 2074 | 미도달 |
| 베트남어 | 192 | 244 | 307 | 383 | 479 | 605 | 783 |
| 태국어 | 94 | 135 | 196 | 288 | 432 | 652 | 1013 |
| 터키어 | 1427 | 2218 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 |
| 일본어 | 192 | 290 | 430 | 641 | 979 | 1521 | 2436 |
| 한국어 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 | 미도달 |
언어별 상위 10단어 빈도 1~10위와 그때까지의 누적 커버리지 — R1 골격이 무엇인지 바로 보임
영어 Indo-Eur Germanic
the3.4% to6.0% you10.8% and12.3% it14.5% of15.9% for16.6% in17.8% on18.6% is19.6%
독일어 Indo-Eur Germanic
ich2.3% ist4.6% nicht6.6% sie8.4% du10.0% das11.6% die13.1% es14.4% und15.6% der16.7%
스페인어 Indo-Eur Romance
de14.8% a25.3% con28.5% bien31.1% aquí32.9% del34.6% al36.2% como37.9% algo39.1% así40.2%
포르투갈어 Indo-Eur Romance
de4.8% a8.1% o11.0% que13.8% e16.5% do18.1% em19.5% da20.9% é22.1% para23.3%
프랑스어 Indo-Eur Romance
je3.1% vous5.8% de8.5% est10.9% pas13.0% le14.9% la16.6% il18.2% que19.7% un21.1%
이탈리아어 Indo-Eur Romance
non3.0% che5.4% di7.8% la9.6% un11.3% il13.0% per14.2% mi15.1% in16.0% una16.9%
러시아어 Indo-Eur Slavic
не3.2% что5.5% ты7.0% это8.6% вы9.8% на11.0% да11.9% он12.8% как13.6% мне14.4%
힌디어 Indo-Eur Indo-Iran
मैं2.0% और3.6% यह4.9% मुझे6.3% है7.5% एक8.7% तुम9.7% वह10.8% आप11.5% हम12.3%
페르시아어 Indo-Eur Indo-Iran
و4.0% به6.8% در9.4% از11.9% که14.2% این15.6% با16.8% را17.8% است18.7% رو19.4%
중국어 Sino-Tibetan
的6.2% 是7.6% 在9.1% 了10.5% 我11.4% 和12.1% 有12.8% 不13.3% 人13.9% 也14.4%
아랍어 Afro-Asiatic
في3.5% من6.6% على8.1% أن9.2% لا10.1% إلى10.9% و11.6% ما12.3% عن12.9% هذا13.4%
인도네시아어 Austronesian
yang2.9% dan5.3% di7.2% ini8.7% dari9.8% untuk10.8% dengan11.8% itu12.8% bisa13.7% aku14.5%
베트남어 Austroasiatic
là1.8% và3.3% có4.7% của5.9% được6.9% một7.9% các8.9% không9.8% trong10.7% cho11.5%
태국어 Tai-Kadai
ไม่2.5% คุณ4.6% ฉัน6.5% ผม8.2% จะ9.9% ที่11.4% ไป12.9% ได้14.2% ว่า15.4% เรา16.5%
터키어 Turkic
ve2.3% bir4.5% bu5.8% için6.6% de7.4% da8.0% çok8.6% ile9.2% ne9.6% daha10.0%
일본어 Japonic
の4.5% は7.1% が9.4% を11.4% に13.2% よ14.5% も15.5% と16.6% で17.5% ね18.3%
한국어 Koreanic
거야0.7% 내가1.3% 그래1.7% 있어2.1% 무슨2.4% 정말2.7% 어떻게3.0% 그럼3.3% 우리3.6% 하지만3.8%
한자 절벽 — 중국어 회화에 나오는 한자를 빈도순으로 누적했을 때, 몇 자면 청취 글자의 몇 %가 보이나 (talkverse-zh 한자 cliff)
단어 cliff는 회화 코퍼스를 jieba로 분절한 토큰 빈도의 누적 커버리지 55/60/70/80% 경계(R1 433 → R4 2,500). 이 앱만의 차별화는 '한자 cliff'로, 회화에 등장하는 한자 빈도를 별도 집계해 209자만으로 청취 89%에 도달함을 회화 시작점으로 삼는다. 막대 = 가중 방식 final 기준(99%까지). 23자로 절반, 107자로 80%, 824자로 99% — 단어 절벽(R1 433단어)보다 훨씬 가파릅니다.
| 목표 커버리지 | final | s | cd |
|---|---|---|---|
| 50% | 23 | 23 | 23 |
| 80% | 107 | 108 | 108 |
| 90% | 205 | 207 | 211 |
| 95% | 345 | 348 | 362 |
| 98% | 600 | 604 | 641 |
| 99% | 824 | 830 | 895 |
| 99.5% | 1,072 | 1,081 | 1,182 |
| 99.8% | 1,425 | 1,436 | 1,601 |
| 99.9% | 1,692 | 1,707 | 1,944 |
| 99.99% | 2,648 | 2,677 | 3,215 |
세 열은 한자 점수 가중 방식(final = 앱 채택, s = 단순 빈도, cd = 작품 보편성 가중)에 따른 필요 한자 수입니다.
단어·한자 절벽 — 일본어 드라마·애니·영화 자막 12,277편 빈도 top 2,500 (talkverse-ja ja_cliff_summary)
| 구간 | 단어 수 | 순위 | 구간 빈도 | 누적 | 구간 한자 | 누적 한자 | 신규 한자 |
|---|---|---|---|---|---|---|---|
| R1 | 294 | 1-294 | 55.20% | 55.20% | 140 | 140 | 140 |
| R2 | 143 | 295-437 | 5.02% | 60.22% | 107 | 226 | 86 |
| R3 | 561 | 438-998 | 10.01% | 70.23% | 383 | 507 | 281 |
| R4 | 1502 | 999-2500 | 10.03% | 80.26% | 910 | 1078 | 571 |
R1 294단어 안에 한자 140자, R1~R3(누적 70%)까지 507자. 앱 한자 덱 80자의 구간 분포: R1 48 / 80(60%) · R2 29 / 80(36%) · R3 61 / 80(76%) · R4 76 / 80(95%).
신규 한자 140자 이전 구간에 없던 한자 · 상위 20
何0.723% 私0.572% 言0.557% 分0.435% 来0.422% 事0.413% 前0.371% 思0.349% 尾0.339% 俺0.321% 要0.300% 流0.276% 君0.256% 今0.249% 嫌0.249% 鋳0.245% 生0.242% 鳴0.209% 照0.208% 本0.206%
신규 한자 86자 이전 구간에 없던 한자 · 상위 20
全0.118% 変0.094% 心0.078% 気0.075% 見0.074% 性0.073% 度0.073% 手0.071% 部0.071% 金0.071% 陽0.069% 味0.061% 力0.042% 教0.042% 訓0.042% 蓙0.042% 茣0.042% 書0.041% 信0.041% 配0.040%
신규 한자 281자 이전 구간에 없던 한자 · 상위 20
最0.093% 付0.087% 合0.083% 親0.079% 似0.065% 笑0.059% 決0.053% 後0.053% 愛0.052% 張0.050% 強0.049% 着0.047% 通0.047% 始0.046% 回0.045% 疲0.045% 文0.045% 勝0.044% 捜0.043% 素0.043%
신규 한자 571자 이전 구간에 없던 한자 · 상위 20
様0.075% 藤0.045% 物0.042% 解0.039% 発0.036% 記0.033% 業0.033% 訳0.032% 小0.032% 苦0.032% 主0.031% 不0.030% 集0.029% 傷0.027% 月0.027% 師0.027% 応0.026% 指0.026% 成0.025% 派0.025%
R1 한자 가중 빈도 TOP 30 회화 골격 294단어 안에서 가장 자주 노출되는 한자 = 학습 우선순위
何0.723% 私0.572% 言0.557% 分0.435% 来0.422% 事0.413% 前0.371% 思0.349% 尾0.339% 俺0.321% 要0.300% 流0.276% 君0.256% 今0.249% 嫌0.249% 鋳0.245% 生0.242% 鳴0.209% 照0.208% 本0.206% 反0.203% 出0.202% 田0.190% 先0.182% 話0.171% 柄0.167% 僕0.164% 増0.164% 暮0.163% 一0.157%
원본 분석 차트 talkverse-ja data/corpus 의 분석 그림과 산출표
이 절의 그림과 표는 또 다른 산출(multilang_cliff_summary)입니다 — 각 언어 상위 N 단어 안에서 누적 55/60/70/80%에 실제로 닿는 순위를 경계로 잡았습니다. 그래서 일본어 R1이 156(앱 채택 294), 영어 R1이 242~251(비교표 154)처럼 위 값들과 다릅니다. 상위 N 안에서 해당 %에 못 닿으면 '미도달'.
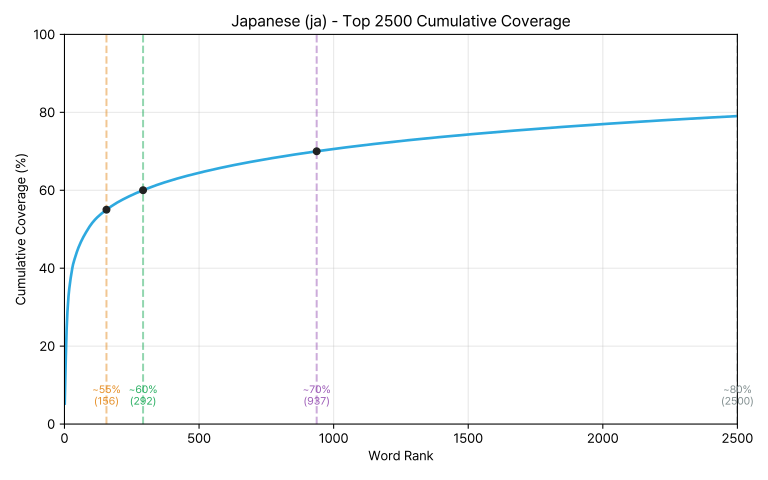
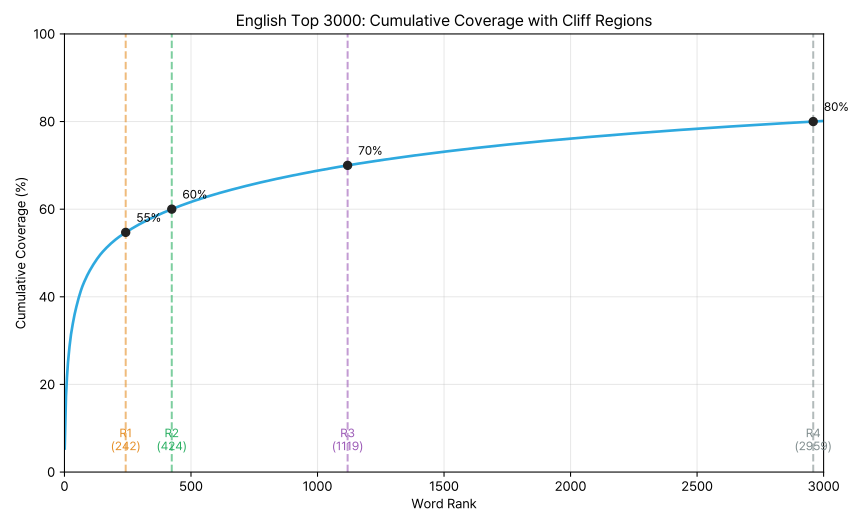
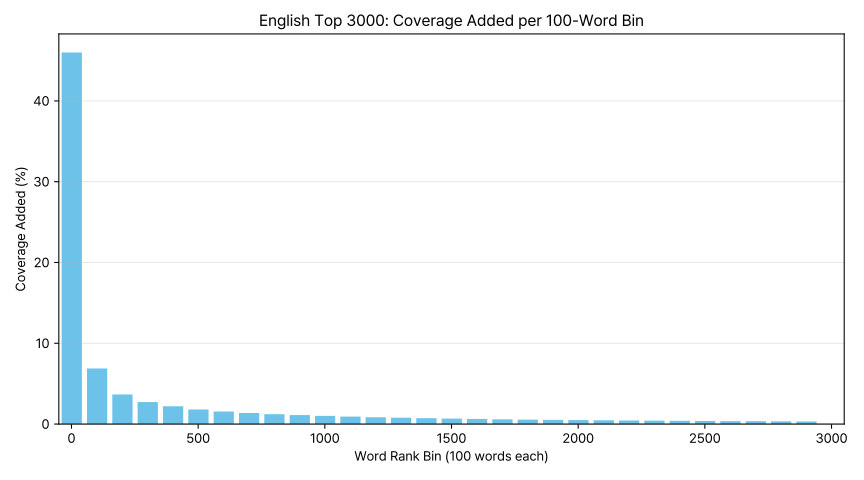
| 언어 | 상위 N | 최대 커버 | R1 55% | R2 60% | R3 70% | R4 80% | 비고 |
|---|---|---|---|---|---|---|---|
| 한국어 | 2,500 | 79.8% | 205 | 334 | 898 | 미도달 | |
| 영어 | 3,000 | 80.1% | 251 | 424 | 1,119 | 2,959 | |
| 중국어 | 2,500 | 71.6% | 681 | 1,006 | 2,186 | 미도달 | |
| 힌디어 | 2,500 | 80.9% | 228 | 353 | 866 | 2,276 | |
| 스페인어 | 2,500 | 77.2% | 184 | 341 | 1,094 | 미도달 | |
| 아랍어 | 2,500 | 58.7% | 1,850 | 미도달 | 미도달 | 미도달 | 상위 2,500이 58.7%까지만 |
| 프랑스어 | 2,500 | 79.3% | 132 | 245 | 822 | 미도달 | |
| 포르투갈어 | 2,500 | 77.6% | 234 | 403 | 1,134 | 미도달 | |
| 인도네시아어 | 2,500 | 77.0% | 403 | 603 | 1,349 | 미도달 | |
| 러시아어 | 2,500 | 60.0% | 1,474 | 2,495 | 미도달 | 미도달 | 상위 2,500이 60.0%까지만 |
| 독일어 | 2,500 | 73.6% | 291 | 513 | 1,638 | 미도달 | |
| 일본어 | 2,500 | 79.0% | 156 | 292 | 937 | 미도달 | |
| 베트남어 | 2,500 | 92.9% | 244 | 307 | 479 | 783 | |
| 터키어 | 2,500 | 56.4% | 2,218 | 미도달 | 미도달 | 미도달 | 상위 2,500이 56.4%까지만 |
| 페르시아어 | 2,500 | 75.6% | 530 | 775 | 1,626 | 미도달 | |
| 이탈리아어 | 2,500 | 75.9% | 272 | 471 | 1,343 | 미도달 | |
| 폴란드어 | 2,500 | 67.2% | 665 | 1,147 | 미도달 | 미도달 | |
| 헝가리어 | 2,500 | 66.1% | 749 | 1,291 | 미도달 | 미도달 | |
| 몽골어 | 2,500 | 65.6% | 961 | 1,508 | 미도달 | 미도달 | |
| 미얀마어 | 2,500 | 99.3% | 10 | 12 | 17 | 34 | 토큰화 문제로 신뢰 불가(상위 34단어로 80%) |
앱 채택 절벽 각 앱이 자체 코퍼스로 산출해 실제로 쓰는 경계 · 절벽 산출 14/21개 언어
| 언어 | R1 | R2 | R3 | R4 | 비고 |
|---|---|---|---|---|---|
| 러시아어 | 156 / 151 | 251 / 95 | 685 / 429 | 1985 / 1275 | 자국 제작 영화·드라마 자막 코퍼스(1,303만 토큰)를 lemma 단위로 집계해 누적 토큰 커버리지 55/60/70/80%에 도달하는 lemma 수를 R1~R4 경계로 삼는다. R1 156 lemma가 회화의 55.44%를 덮고, 이 시점에서 러시아어 문법 시스템(격·동사 활용·양태)이 한 바퀴 닫힌다는 것이 설계 명제다. |
| 중국어 | 433 | 616 | 1238 | 2500 | (정제 페이지 값) jieba 단어·CD 가중, 사용자 정의 R 구간(2026-05-17): 누적 49.3/53.7/62.7/71.6%로 55/60/70/80 원칙과 다름. top1k=59.9%. 별도 한자 cliff: 100자 79%·209자 89%·300자 94%·387자 95%·824자 99%(HSK4 어휘 누적 90.66%) |
| 일본어 | 294 | 437 | 998 / 852 | 2436 / 1944 | (정제 페이지 값) 드라마·애니·영화 자막 12,277편 빈도(ja cliff-report, 앱 확정 기준: R1 1–294·R2 295–437·R3 438–998·R4 999–2,436, R5 2,437+). 뒷값 852/1,944=drama+chat 메모 기준(th cliff-report 통합표). R1 한자 294자 중 N5+N4는 44%뿐 |
| 한국어 | 100 | 500 / 518 | 1500 / 1304 / 916 | 3000 / 2029 | (정제 페이지 값) kiwi 어휘소 lemma 기준(ko cliff-report): R1 top100=47.9%(사용자 인용)/49.7%(측정), 70% 컷 rank 518(R2≈500), 80% 컷 1,304(R3≈1,500), R4 1,501~3,000 확장. mecab_lex는 638/1,566. 916/2,029=drama+chat 메모(통합표). 조사·어미 13개만으로 누적 50% |
| 태국어 | 99 / 109 | 137 / 149 | 286 / 295 | 653 / 642 | (정제 페이지 값) pythainlp newmm 분절. 앞값=공개 자막 말뭉치 2.5억 토큰·사극 904편 블랙리스트 제외(R4 경계 CD 33%). 뒷값=자국 드라마 50편 260K 토큰. 사극 포함 시 R3 412/R4 1,009. 두 코퍼스 규모 6,000배 차이에도 ±10단어 수렴 |
| 몽골어 | L1 골격 120 · TOP 1–120 · 대명사·첨사·후치사·기본 동사 (би·чи·энэ·тэр·байх·болох) | L2 일상 명사·형용사 90 · TOP 121–210 · 수·사물·색·평가 | L3 여행 어휘 20 · TOP 211–230 · 자연·이동·문화 | L4 감정·로맨스 20 · TOP 231–250 · 마음·관계 | 공개 말뭉치 빈도로 추린 몽골어 lemma를 4단계 절벽으로 나눈다. 골격 120개만 익혀도 회화의 절반이 보이고, 210개에서 실제 회화 진입 임계점을 넘긴 뒤 여행·감정 어휘로 확장한다는 설계. |
| 인도네시아어 | 빈도 csv 상 R1 라벨 100단어 (yang·dan·di·itu…, rank 1~120 구간에 R2와 혼재) | 빈도 csv 상 R2 라벨 20단어 (membaca·jelek·kota…) | — | — | zh의 한자 절벽에 대응하는 '어근 절벽'(어근 N개 → 청취 커버리지)을 설계했으나 아직 코퍼스 실측 전. 현재 앱의 R1~R4는 빈도 단어 구간 필터로만 존재하며 placeholder 데이터 상태. |
| 스페인어 | 빈도 CSV region=R1: 190단어 (rank 1~190, A1 위주) | 빈도 CSV region=R2: 10단어 (rank 191~200) | — | — | 스페인어판 cliff는 두 갈래다. 단어 cliff는 zh와 같은 R1~R4 구간 스키마(빈도 CSV region 칼럼)이고, 동사 cliff는 핵심 동사 30→100→300 단계로 회화 커버리지를 실측하려는 계획이다. 현재 데이터는 빈도 200개(수동 샘플)·동사 30개까지만 있어 R3/R4·동사 100/300은 미착수. |
| 프랑스어 | — | 절벽구간 미산출 | |||
| 이탈리아어 | — | 절벽구간 미산출 | |||
| 아랍어 | — | 절벽구간 미산출 | |||
| 힌디어 | 229 | 365 | 944 | 2500 | 힌디어는 상위 1,000단어로 누적 48.6%밖에 덮지 못해 17개 언어 중 절벽이 가장 완만한(=핵심 어휘가 넓게 퍼진) 축에 든다. 비례 R1은 229단어(전체 9.2%)로 R1 순위 7위이나, 절대 누적 50% 도달에는 1,218단어가 필요하다. 앱에는 아직 빈도 CSV가 비어 있어 이 수치는 앱 밖 분석 메모에만 있다. |
| 터키어 | 520 | 722 | 1345 | 2500 | 터키어는 교착어라 어형이 많아 상위 1,000단어 누적이 45.9%에 그치고, 비례 R1이 520단어(전체 20.8%)로 한국어 다음으로 크다. 즉 '조금만 외워도 대화가 뚫리는' 절벽이 없고 어미 활용 학습이 어휘보다 먼저 와야 한다. 앱 빈도 CSV는 아직 비어 있다. |
| 헝가리어 | — | 절벽구간 미산출 | |||
| 포르투갈어 | — | 절벽구간 미산출 | |||
| 독일어 | — | 절벽구간 미산출 | |||
| 페르시아어 | 415 | 603 | 1216 | 2500 | (정제 페이지 값) 공개 빈도표 Top 2,500 기준, 누적 51.95/56.69/66.12/75.56%(55/60/70/80 미달 — 분석적 어순으로 빈도 분산). Top1000=63.46% |
| 베트남어 | 89 / 76 / 77 | 115 / 127 | 199 / 170 | 362 / 320 / 312 | 남부 드라마 방송 음성 ASR 전사와 자막 코퍼스를 음절 단위로 집계해 누적 커버리지 55/60/70/80/90%에 도달하는 음절 수를 R1~R5로 잡는다. R1 76~89 음절 안에 호칭 18개와 주요 종결사 대부분이 들어와 일반 자막 코퍼스보다 2.7배 가파른 절벽을 이루며, 이것이 '호칭+종결사 축' 설계의 근거다. |
| 영어 | 154 | 236 | 639 | 3000 | 영어는 17개 언어 중 절벽이 가장 가파른 축(R1 154단어로 3위, 626단어로 누적 80%)이지만, Grab 앱은 빈도 어휘가 아니라 '구문 경계 듣기'에 초점을 두므로 이 수치는 앱에 반영돼 있지 않다. |
| 미얀마어 | 267 | 366 | 699 | 1425 | (정제 페이지 값) 공개 자막 말뭉치 my, Zawgyi→Unicode 정규화 후 MaxMatch 토크나이저, 누적 ~50/60/70/80%. 유효 영화 54편뿐(th의 1/725)·결합형 미분리로 R3가 th의 2.4배 |
| 폴란드어 | — | 절벽구간 미산출 | |||
각 언어 페이지의 절벽구간 표에서 옮긴 값입니다(메모마다 값이 다르면 / 로 병기, 언어 페이지에 표가 없으면 정제 페이지 값). 카드의 * = 표 값이 설명문이라 대표 숫자만 표시 — 칸에 마우스를 올리면 원문.
언어별 절벽 설계 누르면 펼쳐짐 — 절벽을 어떻게 잡았고 R1에 무엇이 들어가는지, 코퍼스 규모, 근거 메모
러시아어R1 156 / 151 · R2 251 / 95 · R3 685 / 429 · R4 1,985 / 1,275
자국 제작 영화·드라마 자막 코퍼스(1,303만 토큰)를 lemma 단위로 집계해 누적 토큰 커버리지 55/60/70/80%에 도달하는 lemma 수를 R1~R4 경계로 삼는다. R1 156 lemma가 회화의 55.44%를 덮고, 이 시점에서 러시아어 문법 시스템(격·동사 활용·양태)이 한 바퀴 닫힌다는 것이 설계 명제다.
- 자국 코퍼스 규모 2,428작품 · 자막 3,589 · 13,025,903 토큰 · 3,013,631 발화
- 챗 코퍼스 발화 수 10,464,891
- R1 누적 토큰 커버리지 55.44%
- R1 156 lemma로 100% 커버되는 문장 raw 494,713 (16.42%) · unique 표면형 96,573
- R1+R2 문법 골격 단어 81 (대명사 12·전치사 18·접속사 17·불변화사 21 등)
- R1 동사 활용 분류 26개 (1식 규칙 4·2식 규칙 4·1식 변형 7·2식 변형 3·불규칙 8)
- 목표 학습 문장 수 R1 300 + R2 500 + R3 500 + R4 1,000 = 2,300
- R1 격 시스템 슬롯 158
- 앱 cliff 에셋 lemma 수 L1 156 · L2 95 · L3 434 · L4 1,300
근거 메모: notes/02_statistics/key_numbers.md 본표: POS 구분 누적 lemma R1 156(55%)·R2 251(60%)·R3 685(70%)·R4 1,985(80%), R5는 Top5000 미도달. 같은 메모 괄호 주석(POS 무시 unique lemma): R1 151·R2 94·R3 429·R4 1,275. app/README.md는 'R1 156 + R2 95'로 R2 증가분을 95로 표기. 앱 에셋 assets/data/cliff/l1~l4_lemma.tsv 행수 = 156/95/434/1,300(구간별 증가분, 누적 156/251/685/1,985와 일치).
러시아어앱 소개 →중국어R1 433 · R2 616 · R3 1,238 · R4 2,500
단어 cliff는 회화 코퍼스를 jieba로 분절한 토큰 빈도의 누적 커버리지 55/60/70/80% 경계(R1 433 → R4 2,500). 이 앱만의 차별화는 '한자 cliff'로, 회화에 등장하는 한자 빈도를 별도 집계해 209자만으로 청취 89%에 도달함을 회화 시작점으로 삼는다.
- 빈도 wordset Top 2,500
근거 메모: README.md 단어 cliff(jieba 토큰): R1=433 / R2=616 / R3=1238 / R4=2500, Top1k = 59.9%. 별도로 한자 cliff(README.md): Phase1 100자 79% / Phase2 209(216)자 89% / Phase3 300자 94% / Phase4 387자 95%, 자유 회화 단어 727+·한자 824+. docs/PORTING_GUIDE_2026-09.md 1-5의 회화 코퍼스 한자 커버율은 107자 80% · 206자 90% · 359자 95% · 517자 97% · 682자 98%로 README 값과 소폭 상이.
중국어앱 소개 →일본어R1 294 · R2 437 · R3 998 · R4 2,500 / 2,436
일본 드라마·애니·영화 자막 12,277편 빈도 목록 top 2,500을 기준으로 누적 커버리지 55/60/70/80%에 도달하는 순위를 R1~R4 경계로 삼는다. R1 294어가 조사·종조사·인칭·기초동사 등 기능어 위주의 회화 골격이며, 단어 안에서 추출한 한자를 같은 구간으로 나눠 한자 cliff(R1 140자 → R4 누적 1,078자)도 병행한다.
- 회화 빈도 자산 한자 1,078 · 단어 2,500 (R1~R4 라벨)
- top1000 누적 커버리지 70.3% (17개 언어 중 4위권)
근거 메모: data/corpus/ja_cliff_summary.md(자동 생성): R1 1~294(55.20%) / R2 295~437(60.22%) / R3 438~998(70.23%) / R4 999~2500(80.26%), 구간별 단어 수 294·143·561·1,502. data/notes/cliff-report.md·overview.md: R4 = 999~2,436(80% 도달어 2,436), overview 현재상태 표는 R4=2,500. 한자 cliff(ja_cliff_summary): R1 140 / R2 누적 226 / R3 507 / R4 1,078자.
일본어앱 소개 →한국어구간 미산출
명시적 절벽 단계는 없지만 빈도 단어 2,500개에 누적 커버리지(cum_pct)가 붙어 있어, 상위 100 단어만으로 말뭉치의 절반 가까이(47.6%)가 보인다는 점을 보여 준다.
- 조사·어미 19개 (누적 빈도순)
- 빈도 단어 2,500개 (Top2500 누적 79.8%)
근거 메모: R1~R4 구간 구조 없음. 빈도 단어의 누적 커버리지만 존재: Top100 47.6% · Top500 64.2% · Top1000 71.1% · Top2000 77.8% · Top2500 79.8% (assets/seed/vocab.json)
한국어앱 소개 →태국어R1 109 · R2 149 · R3 295 · R4 642
자체 수집 태국 구어 자막 코퍼스(50편, 260,333 토큰)를 pythainlp로 분절해 누적 커버리지 55/60/70/80/90%에 도달하는 단어 수를 R1~R5로 잡는다. R1 109단어에 종결사 17·대명사 14·상/양태 9가 몰려 있어, 러시아어의 '격' 자리를 태국어에서는 '종결사(존비)·대명사(레지스터)·상표지'가 대체한다.
- 구어 코퍼스 50편 · th-ko 41,141쌍 → 정렬 필터 후 28,774 클린쌍 · 260,333 토큰
- R1~R4 tier 단어 수 642 (R1 109 · R2 +40 · R3 +146 · R4 +347)
- 큐레이션 문장 2,200 (R1 200 · R2 500 · R3 500 · R4 1,000) → 앱 chunks 2,200
- 단어장 규모 중요 1,000단어(회화 빈도 937) + 표준 단어 2,115 = 3,052 · README 표기 통합 단어장 4,700+
근거 메모: corpus/HANDOFF.md: R1=109 / R2 누적 149 / R3 295 / R4=642 / R5=1,665 (pythainlp newmm 분절 단어 기준). corpus/th_pos_breakdown.md는 구간별 증가분 R1 109·R2 40·R3 146·R4 347(합 642)로 표기 — 누적값과 일치. 큐레이션 문장 목표는 REPORT_sufficiency_and_classification.md 기준 R1 200/R2 500/R3 500/R4 1,000=2,200, HANDOFF.md 기준 R1 300/R2 500/R3 500/R4 1,000=2,300로 상이.
태국어앱 소개 →몽골어R1 L1 골격 120 · TOP 1–120 · 대명사·첨사·후치사·기본 동사 (би·чи·энэ·тэр·байх·болох) · R2 L2 일상 명사·형용사 90 · TOP 121–210 · 수·사물·색·평가 · R3 L3 여행 어휘 20 · TOP 211–230 · 자연·이동·문화 · R4 L4 감정·로맨스 20 · TOP 231–250 · 마음·관계
공개 말뭉치 빈도로 추린 몽골어 lemma를 4단계 절벽으로 나눈다. 골격 120개만 익혀도 회화의 절반이 보이고, 210개에서 실제 회화 진입 임계점을 넘긴 뒤 여행·감정 어휘로 확장한다는 설계.
- cliff lemma 250개 (120/90/20/20)
- 생존 200 검수 커버리지 200문장 · 토큰 2,761 · OOV 49 · 커버리지 98.2%
근거 메모: 앱 내 명칭은 R이 아닌 L1~L4(+L5 준비 중). assets/data/cliff/l1~l4_lemma.tsv 실측 120/90/20/20 = 250 lemma. 그러나 main_screen.dart 문구는 'L1~L4 lemma 1,985개'라고 표기 — 값 불일치
몽골어앱 소개 →인도네시아어R1 빈도 csv 상 R1 라벨 100단어 (yang·dan·di·itu…, rank 1~120 구간에 R2와 혼재) · R2 빈도 csv 상 R2 라벨 20단어 (membaca·jelek·kota…)
zh의 한자 절벽에 대응하는 '어근 절벽'(어근 N개 → 청취 커버리지)을 설계했으나 아직 코퍼스 실측 전. 현재 앱의 R1~R4는 빈도 단어 구간 필터로만 존재하며 placeholder 데이터 상태.
- 빈도 단어 120행 (R1 100 / R2 20, placeholder)
근거 메모: R1~R4는 빈도 단어 구간 필터 명칭. 실측 csv는 120행뿐이며 R1 100 / R2 20, R3·R4 데이터 없음, cum_pct 전부 0 (코퍼스 실측 전 placeholder). 어근 cliff(04_root_cliff.py)는 계획 단계
인도네시아어앱 소개 →스페인어R1 빈도 CSV region=R1: 190단어 (rank 1~190, A1 위주) · R2 빈도 CSV region=R2: 10단어 (rank 191~200)
스페인어판 cliff는 두 갈래다. 단어 cliff는 zh와 같은 R1~R4 구간 스키마(빈도 CSV region 칼럼)이고, 동사 cliff는 핵심 동사 30→100→300 단계로 회화 커버리지를 실측하려는 계획이다. 현재 데이터는 빈도 200개(수동 샘플)·동사 30개까지만 있어 R3/R4·동사 100/300은 미착수.
- 빈도 단어 200개 (R1 190·R2 10 / A1 153·A2 40·B1 7)
근거 메모: zh의 '단어 cliff'(R1=433/R2=616/R3=1238/R4=2500) 스키마를 그대로 가져왔으나 es는 200단어 수동 샘플 단계 — R1/R2 경계는 실측이 아님. 별도로 '동사 cliff'(핵심 동사 30→100→300 회화 커버리지)를 차별화 IP 후보로 계획(TBD).
스페인어앱 소개 →프랑스어구간 미산출
프랑스어판은 아직 단어 cliff 데이터가 없다. es와 같은 R1~R4 region 스키마의 빈도 화면은 열리지만 CSV가 비어 있어 구간 분석은 미착수.
- 빈도 단어 0행 (헤더만)
근거 메모: 빈도 CSV(lang_es_top.csv)는 헤더만 있고 0행 — R1~R4 구간 데이터 없음. 스키마(rank/region/cefr)와 화면만 es에서 상속.
프랑스어앱 소개 →이탈리아어구간 미산출
이탈리아어판은 아직 단어 cliff 데이터가 없다. es와 같은 R1~R4 region 스키마의 빈도 화면은 열리지만 CSV가 비어 있어 구간 분석은 미착수.
- 빈도 단어 0행 (헤더만)
근거 메모: 빈도 CSV(lang_es_top.csv)는 헤더만 있고 0행 — R1~R4 구간 데이터 없음. 스키마(rank/region/cefr)와 화면만 es에서 상속.
이탈리아어앱 소개 →아랍어구간 미산출
절벽 단계 대신 빈도 순위 5,000 단어를 500·1000·2000·3000·4000·5000 구간으로 잘라 6개 코스에 배분한다. 회화 문장(80턴)은 코스 2~4에 섞여 들어간다.
- 빈도 단어 구간 Top500 500 · Top1000 500 · Top2000~5000 각 1,000
근거 메모: R1~R4 명칭 없음. 대신 빈도 구간 카테고리 Top500(500)·Top1000(500)·Top2000(1000)·Top3000(1000)·Top4000(1000)·Top5000(1000) = 5,000 단어, 코스 1~5 각 1,000~1,020 항목 + 코스 6 20항목
아랍어앱 소개 →힌디어R1 229 · R2 365 · R3 944 · R4 2,500
힌디어는 상위 1,000단어로 누적 48.6%밖에 덮지 못해 17개 언어 중 절벽이 가장 완만한(=핵심 어휘가 넓게 퍼진) 축에 든다. 비례 R1은 229단어(전체 9.2%)로 R1 순위 7위이나, 절대 누적 50% 도달에는 1,218단어가 필요하다. 앱에는 아직 빈도 CSV가 비어 있어 이 수치는 앱 밖 분석 메모에만 있다.
- 빈도 단어 0 (CSV 헤더만)
근거 메모: ja/data/corpus/all17_cliff_summary.md 표3 — 자체 max 55.1%를 80%로 비례 매핑한 R1~R4 단어 수(R1≈55%·R2≈60%·R3≈70%·R4≈80%). 2,500단어 코퍼스, top10 누적 12.3%, top1 मैं. 50% 도달 1,218단어, 55% 2,472단어, 60% 이상 미도달.
힌디어앱 소개 →터키어R1 520 · R2 722 · R3 1,345 · R4 2,500
터키어는 교착어라 어형이 많아 상위 1,000단어 누적이 45.9%에 그치고, 비례 R1이 520단어(전체 20.8%)로 한국어 다음으로 크다. 즉 '조금만 외워도 대화가 뚫리는' 절벽이 없고 어미 활용 학습이 어휘보다 먼저 와야 한다. 앱 빈도 CSV는 아직 비어 있다.
- 빈도 단어 0 (CSV 헤더만)
근거 메모: ja/data/corpus/all17_cliff_summary.md 표3 — 자체 max 56.4%를 80%로 비례 매핑. 2,500단어 코퍼스, top10 누적 10.0%, top1 ve. 50% 도달 1,427단어, 55% 2,218단어, 60% 이상 미도달. R1 크기 순위 17개 중 16위(520단어, 20.8%).
터키어앱 소개 →헝가리어구간 미산출
헝가리어 절벽 구간은 아직 계산되지 않았다. 분석 메모의 출처표에는 '혼합 빈도표 혼합 코퍼스' 대상으로 hu가 적혀 있으나 결과 표에는 빠져 있고, 앱의 빈도 단어 파일은 헤더만 있다.
- 빈도 단어 0 (CSV 헤더만)
근거 메모: 헝가리어는 17개 언어 절벽 분석 표(all17_cliff_summary.md)에 없고 앱 빈도 CSV도 비어 있어 R1~R4 미산출.
헝가리어앱 소개 →포르투갈어구간 미산출
포르투갈어판은 아직 단어 cliff 데이터가 없다. es와 같은 R1~R4 region 스키마의 빈도 화면은 열리지만 CSV가 비어 있어 구간 분석은 미착수.
- 빈도 단어 0행 (헤더만)
근거 메모: 빈도 CSV(lang_es_top.csv)는 헤더만 있고 0행 — R1~R4 구간 데이터 없음. 스키마(rank/region/cefr)와 화면만 es에서 상속.
포르투갈어앱 소개 →독일어구간 미산출
독일어판은 아직 단어 cliff 데이터가 없다. es와 같은 R1~R4 region 스키마의 빈도 화면은 열리지만 CSV가 비어 있어 구간 분석은 미착수.
- 빈도 단어 0행 (헤더만)
근거 메모: 빈도 CSV(lang_es_top.csv)는 헤더만 있고 0행 — R1~R4 구간 데이터 없음. 스키마(rank/region/cefr)와 화면만 es에서 상속.
독일어앱 소개 →페르시아어구간 미산출
절벽·빈도 데이터가 아직 없다. 스페인어 앱 템플릿을 그대로 복사한 빈 구조에 2026-09-11자 초안 콘텐츠만 투입된 상태.
- 빈도 단어 0행
근거 메모: 절벽 구조 없음. 빈도 csv(lang_es_top.csv — es 템플릿 파일명 그대로)는 0행
페르시아어앱 소개 →베트남어R1 89 / 76 / 77 · R2 115 / 127 · R3 199 / 170 · R4 362 / 320 / 312
남부 드라마 방송 음성 ASR 전사와 자막 코퍼스를 음절 단위로 집계해 누적 커버리지 55/60/70/80/90%에 도달하는 음절 수를 R1~R5로 잡는다. R1 76~89 음절 안에 호칭 18개와 주요 종결사 대부분이 들어와 일반 자막 코퍼스보다 2.7배 가파른 절벽을 이루며, 이것이 '호칭+종결사 축' 설계의 근거다.
- 균형 코퍼스 ASR 73편 + 자막 42편 = 523k 토큰 · 5,649 고유음절
- R1 문장 카드 299문장 (1~4단계 R1 200 + 5~8단계 플러팅 99) · 호칭 프리셋 5
- 호칭 변형 DB R1 104문장 × 코어 5 = 520
- R2 챗 대화 50세트 × 8줄 (목표 50 달성)
- 기능어 9부류 (R1~R4 핵심 320단어 중)
- 목표 학습 문장 수 R1 300 + R2 500 + R3 500 + R4 1,000 = 2,300
근거 메모: corpus/HANDOFF.md(균형 코퍼스 ASR 73편+자막 42편, 523k 토큰 음절 기준): R1=89 / R2 누적 115 / R3 199 / R4=362 / R5=762. corpus/analysis_vi/vi_R1_R4_design.md(vi_R_tiers.csv 기준): R1 76 / R2 ≈127 / R3 ≈170 / R4 ≈320. ru 작업폴더 analysis_vi/vi_cliff.md(드라마 ASR 161편만, 588k 토큰): 55%=77 / 60%=99 / 70%=171 / 80%=312, 참고로 일반 자막 코퍼스는 R1 244·80% 783.
베트남어앱 소개 →영어R1 154 · R2 236 · R3 639 · R4 3,000
영어는 17개 언어 중 절벽이 가장 가파른 축(R1 154단어로 3위, 626단어로 누적 80%)이지만, Grab 앱은 빈도 어휘가 아니라 '구문 경계 듣기'에 초점을 두므로 이 수치는 앱에 반영돼 있지 않다.
근거 메모: ja/data/corpus/all17_cliff_summary.md 표3 — 영어 3,000단어 코퍼스, max 91.6%, top10 누적 19.6%, top1 the. 50% 도달 72단어, 80% 도달 626단어. Grab 앱 자체는 빈도·절벽 개념을 쓰지 않음.
영어앱 소개 →미얀마어구간 미산출
절벽 구간 미산출. 미얀마어는 17개 언어 일괄 분석(all17_cliff_summary.md)에 없고, 앱도 빈도 데이터도 없다.
- 원천 코퍼스 보유량 약 3.0GB (자막 85.9MB · 일반 텍스트 2.9GB · 원본 tar.gz 1.9MB · 어휘 등급 메모 436B)
근거 메모: 미얀마어는 절벽 분석 대상 17개 언어에 포함되지 않아 R1~R4 없음.
미얀마어앱 소개 →코퍼스 산출 방법·정제 단계·자료 출처·메모 간 불일치는 정제 페이지에 있습니다. 수치는 개발 메모에서 옮긴 값이라 바뀔 수 있습니다.